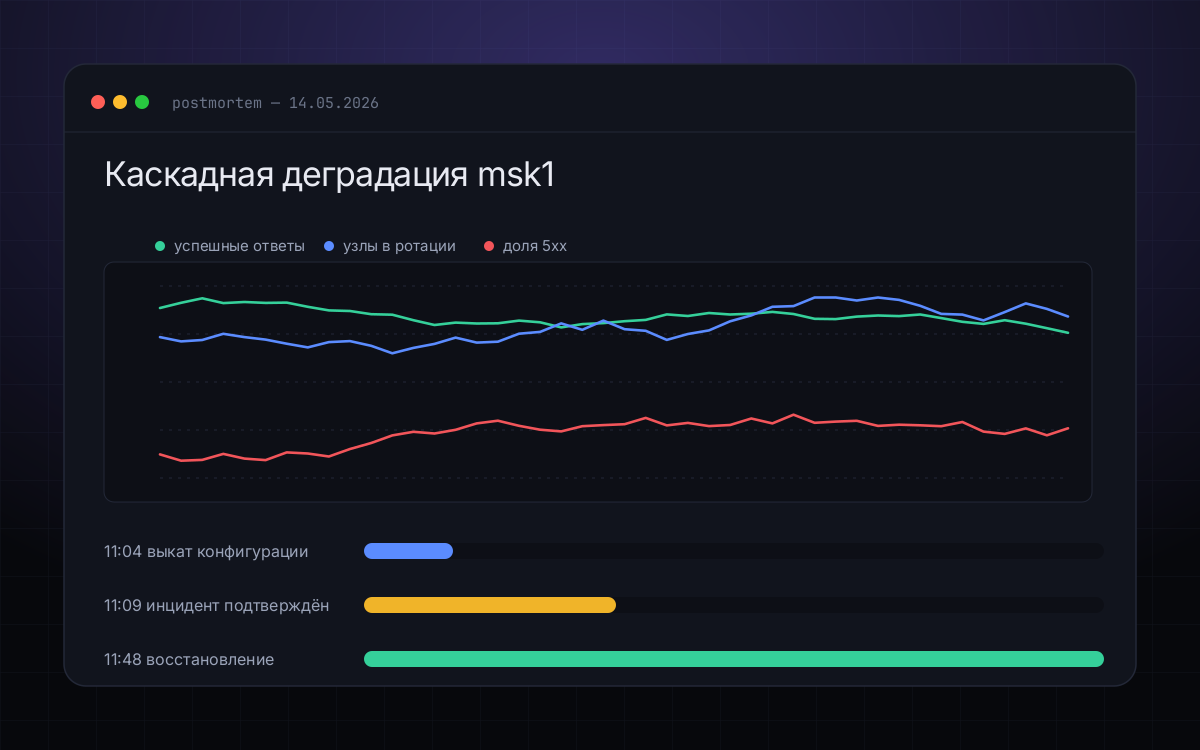
14 мая 2026 года с 11:07 до 11:48 MSK регион msk1 обслуживал запросы с повышенной долей ошибок. Пик — 12% запросов с кодом 503. Другие регионы работали штатно.
Хронология
| Время | Событие |
|---|---|
| 11:04 | Выкат конфигурации балансировщика, шаг 1 из 4 (25% узлов) |
| 11:07 | Рост 503 в msk1, срабатывает алерт |
| 11:09 | Дежурный подтверждает инцидент, выкат остановлен |
| 11:14 | Ошибочная гипотеза: перегрузка узлов, добавлена ёмкость |
| 11:31 | Найдена связь с новым порогом health-проверки |
| 11:38 | Начат откат конфигурации |
| 11:48 | Доля ошибок вернулась к фоновой |
Причина
В новой конфигурации таймаут health-проверки снизился с 5 до 2 секунд. Проверка выполняется тем же HTTP-клиентом, что и пользовательский трафик, и при высокой загрузке узла ответ иногда занимает 2–3 секунды.
Узел помечался нездоровым и выводился из ротации. Его нагрузка перераспределялась на соседей, те начинали отвечать медленнее, и уже они выпадали из ротации. Классическая каскадная деградация.
Мы ужесточили порог, не проверив распределение времени ответа health-проверки под нагрузкой. В спокойном тестовом окружении 2 секунды выглядели безопасным запасом.
Почему не помогло добавление ёмкости
Новые узлы приходили с той же конфигурацией и попадали в тот же цикл. Это увело расследование на 17 минут в сторону.
Что мы изменили
- Health-проверки вынесены на отдельный пул соединений и не конкурируют с пользовательским трафиком.
- Балансировщик не выводит из ротации больше 20% узлов региона одновременно независимо от результатов проверок.
- Изменения порогов health-проверки помечены как рискованные: выкат только по одному узлу с получасовой паузой.
- В рантбук добавлен пункт: при каскадной деградации первым делом проверять недавние изменения конфигурации, а не ёмкость.
Компенсации
Клиентам с SLA на тарифе Scale начислены компенсации автоматически в соответствии с условиями SLA. Обращаться за ними не требуется.